De 35 à 3 segundos: Melhorando a Performance de um Relatório

Um belo dia, recebo um ticket que reclamava de algo: Relatório está demorando demais
Contexto
Estou em um projeto de um SaaS onde se coleta centenas de sinais por minuto para serem inseridos no database do BigQuery e que, eventualmente, são processados para geração de relatórios.
No caso desse post, os relatório em questão busca os dados das viagens geradas por um motorista em um determinado intervalo de tempo e compara seu desempenho com o restante da frota.
Disclaimer
Este sistema ainda está em desenvolvimento e homologação, então, muitas decisões foram tomadas sem o mesmo volume de dados ou criados às pressas para melhorias futuras.
O Problema
Com o aumento do uso, o volume de dados aumentou e eventualmente algumas lentidões foram notadas: O relatório, quando buscado num intervalo de 7 dias, tomava cerca de 30 segundos para devolver a resposta.
E com este ticket foi traçada uma meta: resposta em 3 segundos.
Solucionando
Com isso dito, comecei a analisar o código para procurar os pontos mais lentos.
Usando um Stopwatch, metrifiquei cada etapa do relatório para descobrir que dos 35 segundos da minha request, metade ocorria em 2 buscas ao banco que aconteciam no inicio do processo da Service.
Em resumo, a função recebia um StartDateTime e um EndDateTime e um identificador do veículo e realizava uma lógica parecida com a abaixo:
# Service.cs
// Busca todas as viagens da frota
IEnumerable<VehicleTrip> fleetTrips = await facade.GetTripsAsync(startTime, endTime);

// Filtra as viagens daquele veículo em específico
IEnumerable<VehicleTrip> vehicleTrips = fleetTrips.Where(x => x.VehicleId == vehicleId).ToList();

foreach(var trip in vehicleTrips) {
  // Busca uma lista de eventos para ocorridos na viagem
  trip.Events = await facade.GetEventsAsync(...);
}

// Instancia o objeto de retorno onde é processada a média dos dados
var reportResult = new ReportExample(vehicleTrips);

if(fleetTrips.Any()) {
  // Realizava a comparação de desempenho individual com o da frota inteira
  reportResult.CalculatePercentageDifferenceToTheFleet(fleetTrips);
}

return reportResult;
Se você deu uma boa olhada, já deve ter conseguido encontrar onde estão pelo menos dois dos gaps.
Então, vamos para o primeiro:
Alterando o facade.GetTripsAsync()
Como pode perceber, esse método captura todos os dados de todos os veículos da frota e só os usaria no final do processo, o que me pareceu um esforço desnecessário.
Claro, até havia caching. Assim, nos momentos em que era necessário buscar a quantidade de eventos críticos ou mesmo realizar alguma filtragem, os dados já estavam lá.
Mas mesmo assim, as informações que não seriam exclusivamente do veículo não pareciam ser necessárias em outro momento além daquele método CalculatePercentageDifferenceToTheFleet onde seriam comparadas as médias de desempenho entre o Veículo e a Frota para informações como:
- "O veículo está consumindo, em média, X% a mais do que a frota"
- "O veículo está andando, em média, X% a mais rápido do que a frota"
E não há necessidade de calcular a média da frota no código, uma vez que podemos buscá-la diretamente no banco.
Então essas foram as primeiras alterações:
- O método foi atualizado para buscar unicamente os dados do veículo ;
- Criação do método
facade.GetFleetStats()para retornar as médias de toda a frota sem a necessidade de listar os dados; - Adaptação do método
CalculatePercentageDifferenceToTheFleetpara receber o objeto retornado dofacade.GetFleetStatsao invés da listagem de trips;
# Service.cs
// Busca todas as viagens do veículo
var vehicleTrips = await facade.GetVehicleTripsAsync(startTime, endTime, vehicleId);

foreach(var trip in vehicleTrips) {
  // Busca uma lista de eventos para ocorridos na viagem
  trip.Events = await facade.GetEventsAsync(...);
}

// Executa o calculo das médias de sinais da Frota
FleetStats fleetStats = await facade.GetFleetStatsAsync(startTime, endTime);

// Instancia o objeto de retorno onde é processada a média dos dados
var reportResult = new ReportExample(vehicleTrips);

if(fleetStats != null) {
  // Método alterado para receber FleetStats ao invés de IEnumerable<VehicleTrip>
  reportResult.CalculatePercentageDifferenceToTheFleet(fleetStats);
}

return reportResult;
E o resultado foi: resposta média da API em 18 segundos. Bom? Eu não achei.
O que me levou para a segunda alteração.
Removendo multiplas chamadas ao facade.GetEventsAsync()
Para cada uma das viagens, a aplicação precisa buscar os eventos gerados dentro do intervalo dela. E como já deve ter pensado por conta própria, realizar uma chamada assíncrona para cada uma das trips não era a melhor solução... então a alteração foi bem intuitiva e rápida:
Este código:
var vehicleTrips = await facade.GetVehicleTripsAsync(startTime, endTime, vehicleId);

foreach(var trip in vehicleTrips) {
  trip.Events = await facade.GetEventsAsync(trip.StartDateTime, trip.EndDateTime, trip.VehicleId);
}
Foi substituido por este:
var events = await facade.GetEventsAsync(startTime, endTime);
var vehicleTrips = await facade.GetVehicleTripsAsync(startTime, endTime, vehicleId)
    .Select(trip =>
    {
      trip.Events = events
        .Where(x => x.DateTimeUTC >= trip.StartDateTime &&
                    x.DateTimeUTC <= trip.EndDateTime)
        .ToList();
        return trip;
    });
E o resultado? Resposta media de: 14 segundos. Ainda não chegamos na meta, mas estávamos à caminho.
Ajustando a busca no banco
Neste momento, eu fiz dezenas de alterações em queries tentando diminuir os dados processados e conversões. O que só deve ter reduzido uma média de 2 segundos.
E onde estavam os gaps????? Nos MESMOS lugares: nas comunicações com o BigQuery. Seria isso um problema de performance do mecanismo?
Eu tinha certeza que não, mas o Stopwatch me dizia claramente: nenhuma outra operação leva sequer 1s enquanto as comunicações com o BigQuery levam em média 6s.
Então, fui olhar a implementação da classe de conexão.
Aqui vai uma pequena explicação:
A classe BigQuery.cs que vou mostrar faz parte dos building blocks da aplicação e precisa ser genérico ao ponto de converter os dados nos formatos corretos das propriedades.
O código que encontrei foi parecido com esse:
# BigQuery.cs
public async Task<List<T>> GetQueryResultsAsync<T>(string query)
{
  using var bigQueryClient = bqClientFactory.Create();
  var job = await bigQueryClient.CreateQueryJobAsync(query);

  // Lista de retorno
  var list = new List<T>();

  var bigQueryRows = await bigQueryClient.GetQueryResultsAsync(job.Reference);
  if ((bigQueryRows.SafeTotalRows ?? 0) > 0)
  {
    // Para cada linha retornada do banco...
    foreach (BigQueryRow row in bigQueryRows)
    {
      T data = default;

      // Converte a linha para o objeto T chamando o método de ParseRow.
      data = ParseRow<T>(row);

      // Adiciona na lista que será retornada
      list.Add(data);
    }
  }

  return list;
}
O primeiro problema a ser explorado:
- O uso do
List<T>.
Se você não sabe como o List funciona, aqui vai uma breve explicação...
Para a criação de um array você precisa fornecer o tamanho dele, ou seja, quantos itens ele poderá guardar e este tamanho será imutável!
Ex.:
var arr = new int[8];
Console.WriteLine("Tamanho do arr: {0}", arr.Length);
// Tamanho do arr: 8

var arr2 = new int[] { 0, 1, 2, 3, 4, 5, 6, 7 };
Console.WriteLine("Tamanho do arr2: {0}", arr2.Length);
// Tamanho do arr2: 8
Mas porque não precisamos informar um tamanho para o List?
Quando você gera um List, ele cria um array de tamanho 0 e quando você adiciona itens dentro dele com o .Add() ele gera um NOVO array com tamanho 4, vai atribuir o valor do array anterior ao novo e descartar o velho.
"E se eu rodar o .Add() 5 vezes?"
Ele criará um novo array de tamanho 8 e assim seguirá: todas as vezes que exceder o tamanho, um novo array será criado com o DOBRO do tamanho que vai receber o valor do antigo que será descartado.
Ex.:
var list = new List<int>();
Console.WriteLine("Itens: {0}, Capacidade: {1}", list.Count, list.Capacity);
// Itens: 0, Capacidade: 0

list.Add(0);
Console.WriteLine("Itens: {0}, Capacidade: {1}", list.Count, list.Capacity);
// Itens: 1, Capacidade: 4

list.Add(1);
list.Add(2);
list.Add(3);
list.Add(4);
Console.WriteLine("Itens: {0}, Capacidade: {1}", list.Count, list.Capacity);
// Itens: 5, Capacidade: 8
Já entendeu o problema? Então, haverão vários cenários em que teremos dados duplicados em dois arrays diferentes. E quanto maior a lista tratada, maior o tempo de processamento e a memória alocada.
Então, a alteração foi a seguinte:
- A remoção do
List<T> - A substituição do foreach por um
.Select()com conversão direta
O que deixou o metódo mais ou menos assim:
#BigQuery
public async Task<List<T>> GetQueryResultsAsync<T>(string query)
{
  using var bigQueryClient = bqClientFactory.Create();
  var job = await bigQueryClient.CreateQueryJobAsync(query);

  return (bigQueryRows.SafeTotalRows ?? 0) > 0
      ? bigQueryRows.Select(ParseRow<T>).ToList()
      : new List<T>();
}
E qual foi o resultado disso????????? Uma resposta média de 6 segundos!!!!!!
Nesse momento eu olhei pra trás, e vendo que a versão anterior ainda conseguia levar até 40 segundos, eu quase me senti satisfeito com o resultado....
Quase.
Isso porque o ticket dizia "3 segundos". O que me levou a analizar o método ParseRow que é chamado pelo método que acabamos de alterar.
Analisando o ParseRow
Ele tem uma função bem simples: Ao receber a linha, ele deve instanciar o genérico T e iterar sobre cada uma das colunas da row e buscá-la nas propriedades de T. Veja:
#BigQuery
private T ParseRow<T>(BigQueryRow row)
{
  // Criação de instância do genérico
  T result = Activator.CreateInstance<T>();
  // Armazena todas as propriedades do objeto
  var typeProperties = typeof(T).GetProperties();

  // Loop para iterar cada coluna...
  for (int i = 0; i < row.Schema.Fields.Count; i++)
  {
    // Armazena nome e valor do campo
    var field = row.Schema.Fields[i];
    var value = row.RawRow.F[i].V?.ToString();

    // Confere se a coluna atual existe no objeto
    var matchingProperty = typeProperties.FirstOrDefault(x => x.Name.ToLower() == field.Name.ToLower());

    // Caso não encontre ou não tenha valor... skip.
    if (matchingProperty == null || string.IsNullOrWhiteSpace(value))
      continue;

    // Converte e atribui dados conforme o tipo da propriedade
    // ...
  }

  return result;
}
E a pergunta principal foi "O que dá pra melhorar?" e a resposta estava na variável typeProperties.
Ela armazena cada uma das propriedades do objeto T, mas isso acontece para cada uma das linhas retornadas do banco... o que quer dizer que se houver um resultado de 1800 linhas para um objeto de 12 propriedades.... bem, você entendeu.
Então, a melhor solução é fazer a aplicação buscar uma única vez e reutilizar a informação coletada.
E como o método GetQueryResultsAsync é chamado algumas vezes durante o processo e durante todo o ciclo de vida da aplicação, melhor do que armazenar numa unica variável seria criar uma tabela como caching.
O que deixou o código mais ou menos assim:
#BigQuery.cs

private static readonly ConcurrentDictionary<Type, PropertyInfo[]> _typePropertiesCache = new ConcurrentDictionary<Type, PropertyInfo[]>();

private T ParseRow<T>(BigQueryRow row)
{
  T result = Activator.CreateInstance<T>();
  var typeProperties = typeof(T).GetProperties();
  var typeProperties = _typePropertiesCache.GetOrAdd(typeof(T), t => t.GetProperties());
  /*
      [...]
  */

  return result;
}
Com isso, a aplicação armazenaria uma única vez as informações de um objeto e nunca mais o consultaria, poupando armazenamento e tempo de processamento.
E agora, meus amigos... Com isso, chegamos a marca média dos........................................
3.2 segundos

Mas ainda faltava algo...
Threading
Depois de tudo isso, ainda havia uma coisa que poderia ser alterada lá na Service.
Das 3 chamadas ao facade, somente uma delas precisava da resposta de outra.
Então, não havia a necessidade de esperar chamada por chamada para montar o resultado desde que eu garanta que todas foram executadas.
E com isso em mente, nosso código da service foi atualizado para algo assim:
# Service.cs
// Declaração das chamadas
var eventsTask = facade.GetEventsAsync(startTime, endTime);
var vehicleTripsTask = facade.GetVehicleTripsAsync(startTime, endTime, vehicleId);
var fleetStatsTask = facade.GetFleetStatsAsync(startTime, endTime);

// Aguardando a execução de todas simultâneamente
await Task.WhenAll(eventsTask, vehicleTripsTask, fleetStatsTask);

// Aplicando o "await" da task que já está completa
var events = await eventsTask;

// Aplicando o "await" da task que já está completa
var vehicleTrips = (await vehicleTripsTask)
    .Select(trip =>
    {
      trip.Events = events
        .Where(x => x.DateTimeUTC >= trip.StartDateTime &&
                    x.DateTimeUTC <= trip.EndDateTime)
        .ToList();
        return trip;
    });

// Aplicando o "await" da task que já está completa
FleetStats fleetStats = await fleetStatsTask;

var reportResult = new ReportExample(vehicleTrips);
if(fleetStats != null) {
  reportResult.CalculatePercentageDifferenceToTheFleet(fleetStats);
}

return reportResult;
Conclusão
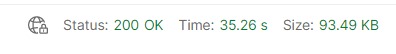
Com isso, eu decidi rodar mais uma vez a versão existente e compará-la com a minha.
E esses foram os resultados:
A versão antes da change:
A versão atualizada: